PitNow는 결제와 예약을 한 번에 저장하지 않습니다. 토스 결제 승인, 예약 생성, 결제 상태 확정, 상태 변경 기록이 차례로 이어집니다. 그래서 중간 단계에서 요청이 끊기면 데이터가 서로 어긋난 채로 남습니다.
예약 겹침에 관한 글을 쓰면서 결제 코드를 다시 읽다가, 실제로 그런 경로를 찾았습니다. 결제 승인 뒤 예약 생성에 실패하면 결제사 취소를 호출하지 않고 결제 상태만 환불로 바꾸는 경로였습니다. 고객의 돈은 빠져나갔는데 시스템에는 환불된 것으로 남을 수 있습니다.
경로 하나는 고치면 됩니다. 더 신경 쓰인 것은 비슷한 불일치가 또 생겨도 고객 문의 전까지 알 방법이 없다는 점이었습니다. 이 글은 이런 상태를 매일 아침 찾아서 정리해 주는 운영 점검을 만든 과정입니다.
먼저 무엇이 이상인지 정의했다
"데이터가 이상하다"는 말로는 아무것도 자동화할 수 없습니다. 그래서 "이 상태라면 저 값이 있어야 한다"는 문장으로 쓸 수 있는 것만 골랐습니다. 이렇게 쓰면 SQL 조건 하나가 됩니다.
| 규칙 | 심각도 | 조건 |
|---|---|---|
| 승인 후 확정되지 않은 결제 | 치명 | 승인 후 15분이 지나도 APPROVED에 머묾 |
| 환불 근거가 없는 환불 완료 결제 | 치명 | 최근 30일 안에 REFUNDED가 됐는데 결제사 취소 기록도, 수동 환불 확인 기록도 없음 |
| 결제 금액과 예약 총액 불일치 | 치명 | 확정된 예약 결제의 금액이 예약 총액과 다름 |
| 오래 남은 환불 확인 필요 결제 | 주의 | REFUND_PENDING으로 24시간 넘게 남음 |
| 상태 변경 기록이 맞지 않는 예약 | 주의 | 현재 상태와 마지막 상태 기록이 다르거나 기록이 없음 |
| 점유 시간이 지나도 이용 중인 예약 | 주의 | 리프트 점유 종료 시각이 지났는데 체크인이나 이용 중 |
| 종료 후에도 확정 상태인 예약 | 참고 | 종료 6시간 뒤에도 확정 상태 |
기준값마다 이유를 붙였습니다.
- 15분: 정상적인 결제 확정 흐름이 끝나기에 충분한 시간입니다. 너무 짧으면 진행 중인 결제까지 이상으로 잡힙니다.
- 최근 30일: 오래된 과거 데이터가 매일 같은 경고를 반복하지 않게 했습니다.
- 상태 기록 규칙의 시작일: 상태 변경 기록을 필수로 정한 뒤에 만든 예약만 봅니다. 그 전 데이터는 기록이 없는 것이 정상입니다. 방금 만든 예약은 기록이 저장되기 전일 수 있어 5분 기다립니다.
규칙은 SQL 함수 하나에 모았다
규칙 7개는 ops_detect_anomalies(p_now) 함수 하나에 UNION ALL로 모았습니다. 규칙마다 규칙 코드, 심각도, 대상, 판단 근거로 이뤄진 같은 모양의 행을 돌려줍니다. 이 점검을 만들게 한 환불 규칙은 이렇습니다.
-- 최근 30일 안에 환불 완료로 바뀌었지만
-- 결제사 취소 기록도, 수동 환불 확인 기록도 없는 Toss 결제
SELECT
  'PAYMENT_REFUNDED_WITHOUT_EVIDENCE',
  'CRITICAL',
  'PAYMENT',
  p.id,
  jsonb_build_object(
    'payment_status', p.status,
    'amount', p.amount,
    'failure_code', p.failure_code
  )
FROM payments p
WHERE p.status = 'REFUNDED'
  AND p.provider = 'TOSS'
  AND p.updated_at >= p_now - interval '30 days'
  AND NOT (p.metadata ? 'refund')
  AND NOT (p.metadata ? 'manualRefundConfirmed')
결제 취소 API를 거친 환불은 metadata.refund에, 운영자가 직접 확인한 환불은 metadata.manualRefundConfirmed에 기록이 남습니다. 둘 다 없다면 누구도 실제 환불을 확인하지 않은 것입니다.
현재 시각을 now()로 쓰지 않고 p_now 인자로 받은 이유는 테스트입니다. 기준 시각을 고정해야 "승인 후 5분은 정상, 30분은 이상"처럼 경계 양쪽에 데이터를 넣고 결과를 비교할 수 있습니다.
한 번 찾고 끝나지 않게 추적했다
매일 점검하면 같은 이상이 매일 다시 잡힙니다. 그대로 쌓으면 운영자는 어제 본 목록을 오늘 또 봐야 합니다. 그래서 이상 하나를 해결될 때까지 한 행으로 추적했습니다.
-- 같은 대상의 같은 이상은 해결되기 전까지 한 행으로만 추적한다.
CREATE UNIQUE INDEX uq_ops_anomalies_active
  ON ops_anomalies(rule_code, entity_id)
  WHERE status IN ('OPEN', 'ACKNOWLEDGED');
부분 유니크 인덱스라서 해결된 행은 이 제약에서 빠집니다. 해결된 뒤 같은 문제가 다시 생기면 새 행이 만들어지고, 재발 이력이 남습니다. 점검 함수는 이 인덱스를 기준으로 upsert합니다.
INSERT INTO ops_anomalies AS existing (...)
SELECT ... FROM ops_detect_anomalies(p_now) AS detected
ON CONFLICT (rule_code, entity_id) WHERE status IN ('OPEN', 'ACKNOWLEDGED')
DO UPDATE SET
  details = excluded.details,
  last_detected_at = excluded.last_detected_at,
  detection_count = existing.detection_count + 1,
  last_run_id = excluded.last_run_id
RETURNING (xmax = 0) AS is_new- 처음 발견하면 새 행을 만들고, 이미 추적 중이면 발견 횟수만 올립니다. 새로 넣은 행은
xmax가 0이라서 이번 점검의 신규 건수를 따로 셀 수 있습니다. - 이번 점검에서 다시 발견되지 않은 이상은 데이터가 바로잡힌 것으로 보고 자동으로 닫습니다.
- 운영자가 '확인'을 눌러도 데이터가 그대로면 계속 같은 행으로 추적합니다.
하나 더 신경 쓴 것은 동시 실행입니다. 매일 도는 크론과 운영자의 수동 실행이 겹치면, 한쪽이 다른 쪽의 탐지 결과를 보지 못하고 "다시 발견되지 않았다"며 잘못 닫을 수 있습니다. 그래서 점검 함수의 시작에서 advisory lock을 잡아 한 번에 하나만 실행되게 했습니다.
PERFORM pg_advisory_xact_lock(hashtext('ops_record_anomaly_run'));탐지, 기록, 자동 해결이 함수 하나의 트랜잭션 안에서 끝나기 때문에, 중간에 실패해도 반쯤 기록된 점검이 남지 않습니다.
AI에게 맡긴 것과 맡기지 않은 것
탐지 결과만으로도 쓸 수는 있지만, 운영자에게 필요한 것은 목록보다 오늘 무엇부터 봐야 하는지입니다. 이 정리를 Claude API에 맡기되, 역할을 좁게 나눴습니다.
| 맡긴 것 | 맡기지 않은 것 |
|---|---|
| 찾은 이상을 규칙별로 묶고 우선순위 매기기 | 무엇이 이상인지 판단하기 |
| 원인 후보와 운영자가 할 일을 짧게 쓰기 | 전체 심각도 정하기 |
| 반복 패턴이나 데이터만으로 판단하기 어려운 점 적기 | 이상을 새로 만들거나 빼기 |
AI에게 원본 데이터를 보여 주고 이상한 점을 찾게 하는 방법도 있었습니다. 하지만 그러면 없는 문제를 만들거나 있는 문제를 빠뜨릴 수 있습니다. 치명적인 이상이 요약에서 빠지면 점검을 하는 의미가 없습니다. 그래서 탐지는 결과가 항상 같은 SQL 규칙에 두고, AI는 이미 찾은 결과를 정리하는 데만 썼습니다.
보내는 데이터부터 줄였다
결제와 예약 데이터를 외부 API로 보내는 일이라, 운영 판단에 필요한 사실만 보냈습니다.
// AI 요약에 보내도 되는 사실만 허용 목록으로 고른다.
const allowedFactKeys = new Set([
  "payment_status",
  "amount",
  "failure_code",
  "minutes_since_approved",
  "reservation_status",
  // ...
]);

function toFactValue(value: unknown) {
  // ...
  if (typeof value === "string") {
    const trimmed = value.trim();

    if (numericValue.test(trimmed)) {
      return Number(trimmed);
    }

    // 상태나 코드 같은 대문자 식별자만 그대로 두고, 자유 텍스트는 내용을 보내지 않는다.
    return enumLikeValue.test(trimmed) ? trimmed : "[masked]";
  }
}- 허용 목록에 없는 키는 보내지 않습니다. 사용자, 차량, 정비소를 알아볼 수 있는 정보는 애초에 목록에 없습니다.
- 문자열은
REFUNDED같은 대문자 코드와 숫자만 그대로 보내고, 나머지는[masked]로 바꿉니다. 허용한 키에 실수로 자유 텍스트가 들어가도 내용은 나가지 않습니다. - 예약이나 결제 ID 대신
A1,A2같은 참조만 보내고, 참조와 실제 ID의 연결은 서버에만 남깁니다. - 한 번에 최대 40건만 보내고, 나머지는 개수만 알립니다.
응답 형식은 스키마로 고정했다
응답 형식은 Zod 스키마로 정의하고 structured outputs로 받았습니다. 형식이 깨진 JSON을 따로 처리하지 않아도 됩니다.
const response = await client.beta.messages.parse({
  model: "claude-opus-5",
  max_tokens: 16000,
  betas: ["server-side-fallback-2026-07-01"],
  fallbacks: "default",
  output_config: {
    effort: "low",
    format: betaZodOutputFormat(opsLlmReportSchema),
  },
  system: OPS_REPORT_SYSTEM_PROMPT,
  messages: [
    {
      role: "user",
      content: `오늘 이상 탐지 결과입니다.\n\n${JSON.stringify(payload)}`,
    },
  ],
});
effort: "low": 이미 정리된 데이터를 요약하는 일이라 깊은 추론이 필요 없습니다.fallbacks: "default": 요청한 모델이 정책상 응답을 거절하면 API가 대체 모델로 한 번 더 실행합니다.
응답도 그대로 믿지 않았다
형식이 맞아도 내용은 틀릴 수 있습니다. 그래서 응답을 저장하기 전에 한 번 더 걸렀습니다.
// 우선순위는 1~3만 허용하고, 심각도가 정한 것보다 느긋하게 매길 수는 없다.
function toPriority(value: number, severity: OpsAnomalySeverity) {
  const floor = priorityForSeverity(severity); // 치명 1, 주의 2, 참고 3

  if (!Number.isInteger(value) || value < 1) {
    return floor;
  }

  return Math.min(value, floor);
}- 입력에 없던 참조나 규칙 코드는 버립니다.
- 참조가 가리키는 이상의 규칙과 AI가 묶은 규칙이 다르면 버립니다.
- AI가 빠뜨린 이상은 규칙에 미리 적어 둔 원인과 조치로 채우고, 채웠다는 사실을 리포트에 남깁니다.
- 전체 심각도는 AI의 답이 아니라 데이터로 계산합니다.
그래서 AI가 어떤 답을 내도 리포트에는 모든 이상이 들어갑니다.
API 키가 없거나, 호출이 실패하거나, 응답을 확인하지 못하면 규칙에 적어 둔 설명으로 요약을 만듭니다. 탐지와 기록은 AI를 호출하기 전에 이미 끝나 있어서, AI 장애가 점검 자체를 막지 않습니다.
운영자가 보는 화면
매일 오전 9시대에 Vercel Cron이 점검 API를 호출하고, 결과는 관리자 화면에서 봅니다. 크론 API는 Authorization 헤더에 담긴 CRON_SECRET이 맞을 때만 실행됩니다.
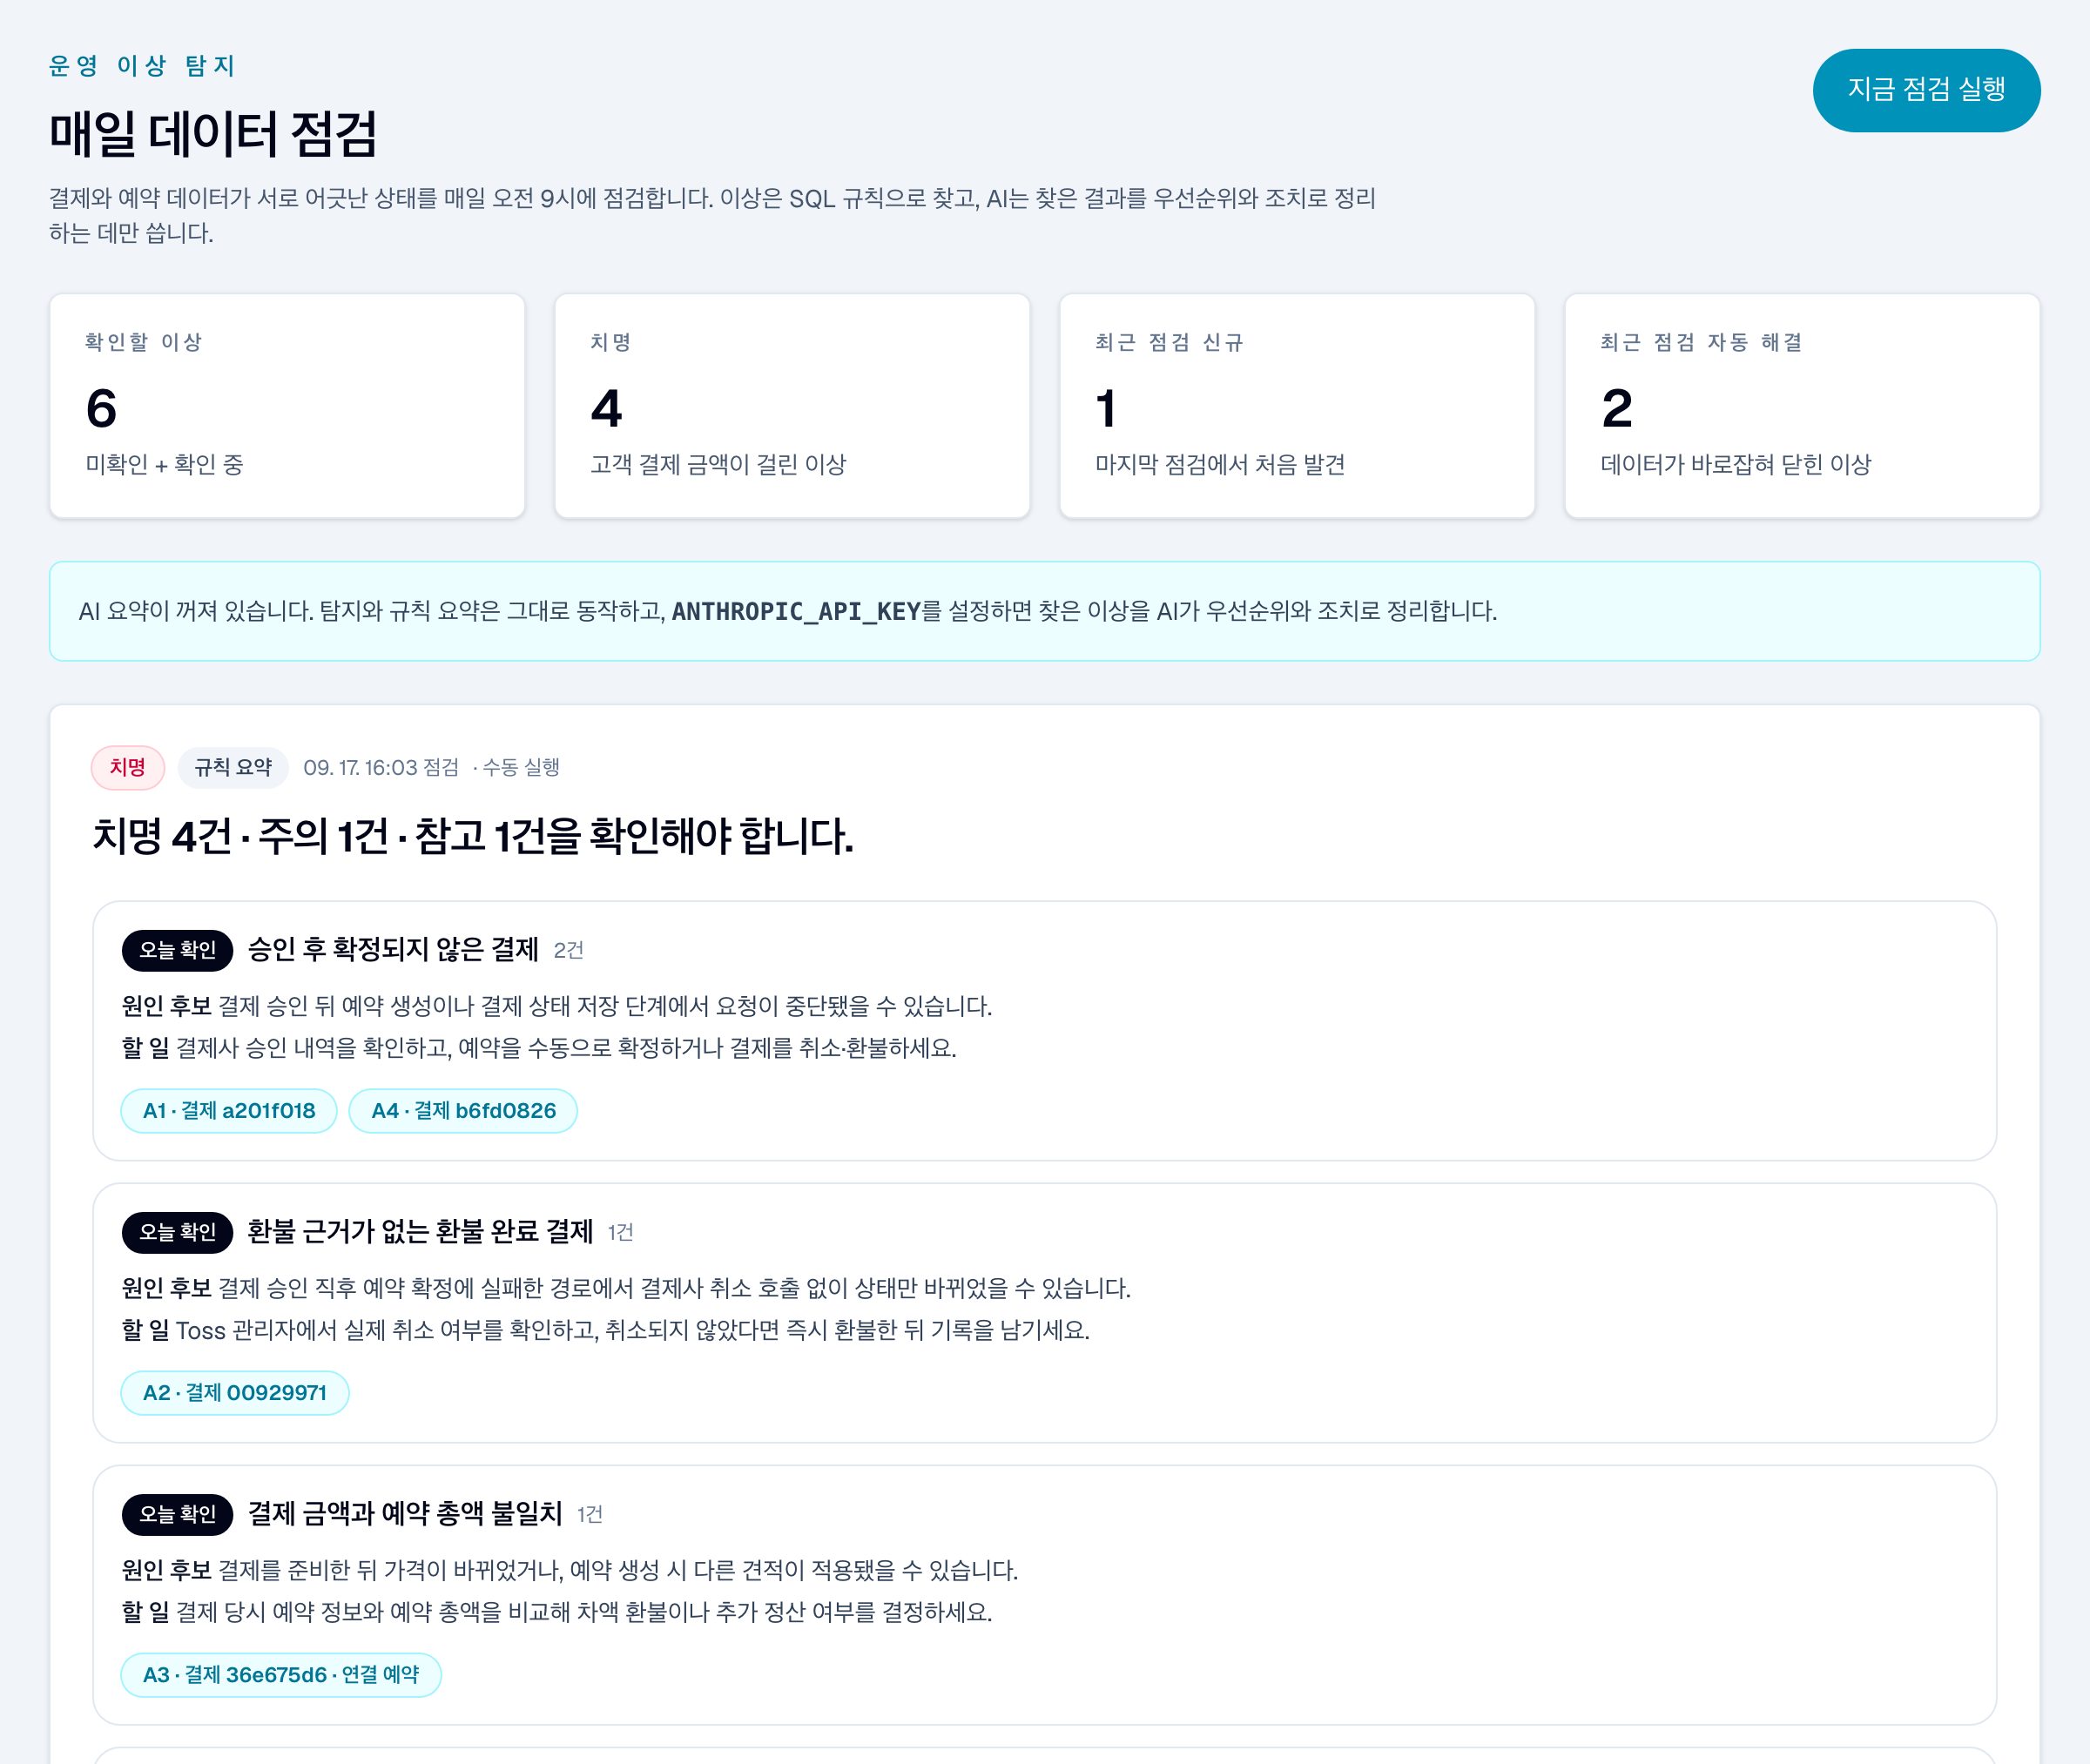
로컬 테스트 데이터로 실행한 화면입니다. API 키 없이 실행해 규칙 기반 요약이 표시됐습니다.
리포트의 참조를 누르면 해당 예약이나 결제로 이동합니다. 목록에서는 이상마다 판단 근거를 보여 주고, 확인과 해결 처리에 메모를 남길 수 있습니다.
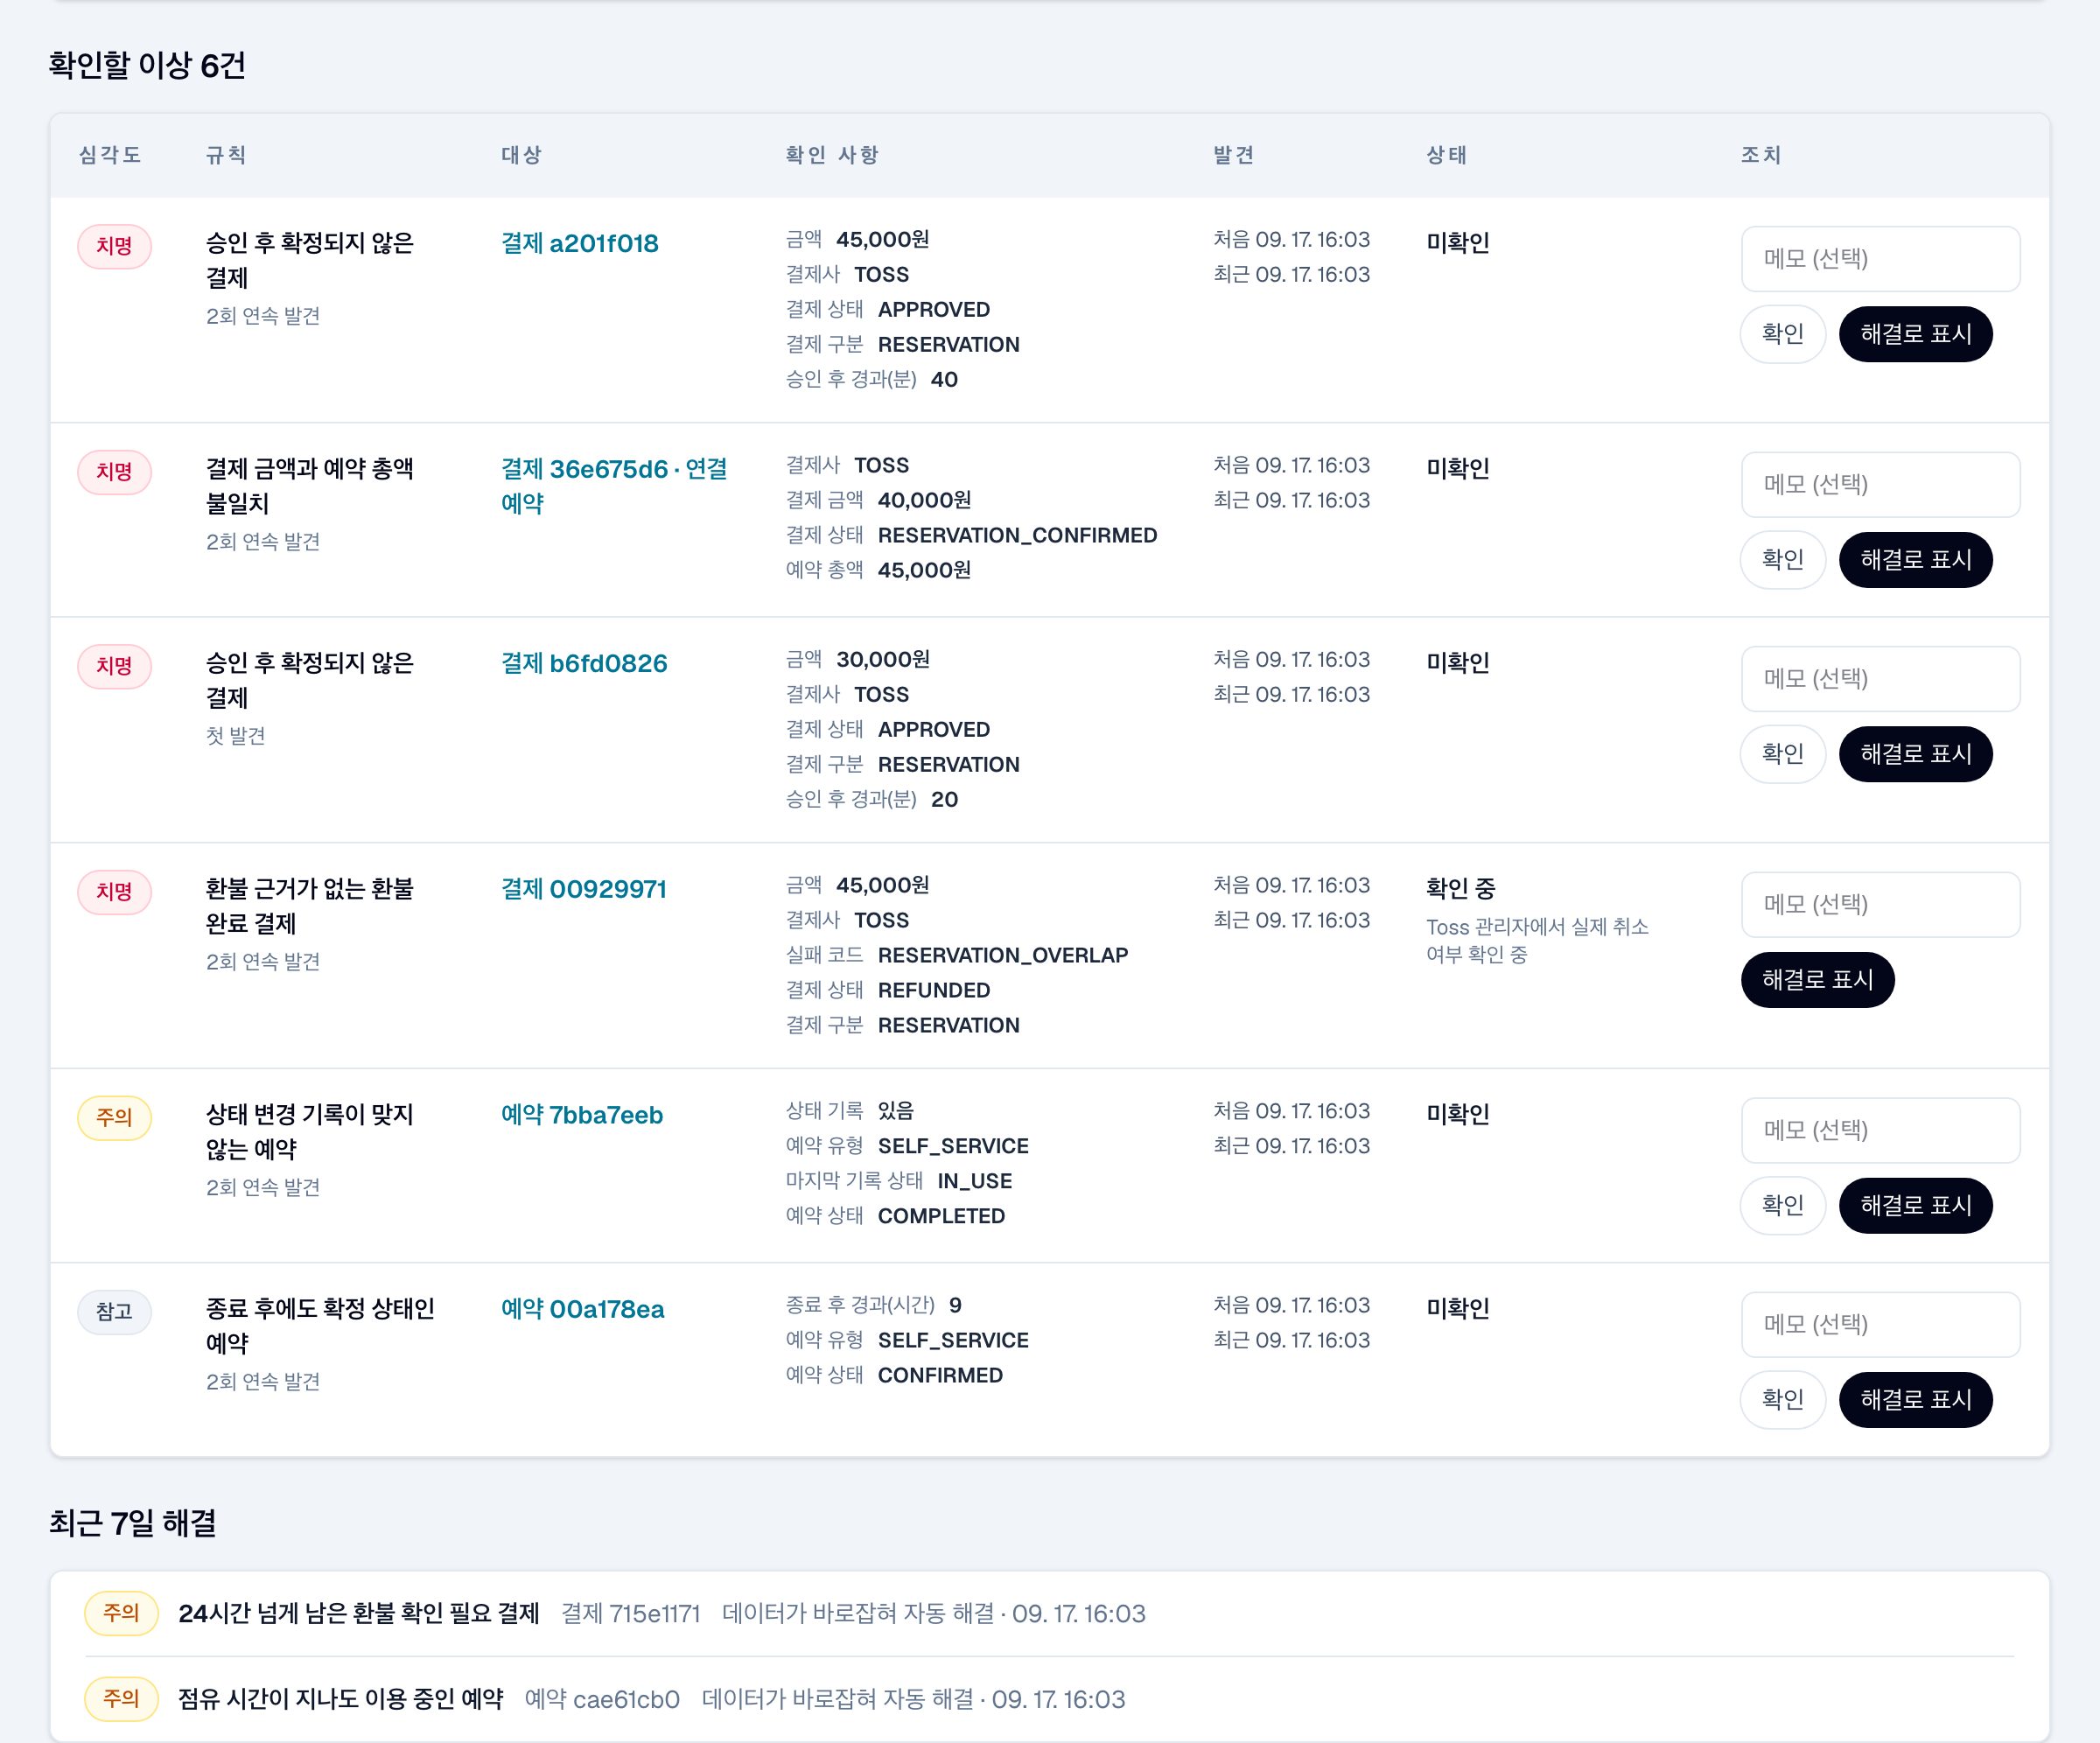
운영자가 메모를 남기고 확인 중으로 바꾼 이상, 데이터가 바로잡혀 자동으로 닫힌 이상입니다.
검증: 실제 마이그레이션 SQL을 테스트에서 실행했다
규칙이 SQL에 있으니 SQL 자체를 테스트해야 했습니다. 로컬에 데이터베이스 서버를 띄우지 않고, WASM으로 동작하는 PostgreSQL인 PGlite에서 실제 마이그레이션 파일을 그대로 실행했습니다. 테스트용 스키마에는 규칙이 읽는 컬럼과 Supabase의 기본 역할(anon, authenticated, service_role)만 옮겼습니다.
test("같은 이상은 한 행으로 추적하고, 데이터가 바로잡히면 자동으로 닫고, 재발하면 새로 쌓는다", async () => {
  // ...
  expect(await recordRun(db, "MANUAL", 0)).toMatchObject({ new_findings: 1 });
  expect(await recordRun(db, "CRON", HOUR)).toMatchObject({ new_findings: 0 });

  // 수동 환불 확인이 기록되면 다음 점검에서 자동으로 닫힌다.
  // ...
  expect(await recordRun(db, "CRON", 3 * HOUR)).toMatchObject({
    total_findings: 0,
    resolved_findings: 1,
  });
});
SQL 테스트는 네 가지를 확인합니다.
- 규칙마다 위반한 행은 찾고, 경계 밖의 정상 행은 무시하는지. 승인 5분 뒤의 결제, 30일이 지난 환불, 상태 기록을 필수로 정하기 전의 예약 같은 데이터를 함께 넣었습니다.
- 발견, 반복 발견, 확인, 자동 해결, 재발이 의도대로 기록되는지
- 알 수 없는 실행 방식을 거부하는지
- anon, authenticated 역할로는 함수와 결과 테이블에 접근할 수 없고 service_role만 실행할 수 있는지
AI 쪽은 네트워크 없이 검증할 수 있는 부분을 테스트했습니다. 보내는 데이터에 UUID, 전화번호, 차량 번호가 없는지, 40건이 넘으면 나머지를 개수로만 보내는지, 없는 참조와 느슨한 우선순위를 바로잡는지 확인합니다.
마지막으로 Supabase의 REST API를 PGlite 위에 흉내 낸 테스트 서버에 앱을 연결해, 크론 인증(시크릿이 없으면 401, 맞으면 200), 수동 점검, 확인과 해결 처리를 화면에서 확인했습니다.
돌아보며
처음 떠올린 질문은 "AI로 무엇을 할 수 있을까"가 아니라 "고객 문의 전에 알 수 있을까"였습니다. 그 질문에는 매번 같은 기준으로 빠짐없이 찾는 일이 필요했고, 그건 규칙이 더 잘하는 일이었습니다. AI는 사람이 매일 하기 번거로운 정리를 맡을 때 가장 쓸모 있었습니다.
지금 상태와 다음 과제는 이렇습니다.
- 운영 반영: 코드는 테스트를 마치고 main에 병합했습니다. 운영 데이터베이스에 마이그레이션을 적용하고 첫 점검 결과를 확인하는 것이 다음 단계입니다.
- 알림: 치명 이상이 새로 생기면 화면을 열기 전에 알 수 있도록 메일이나 메신저 알림을 붙일 계획입니다.
- 요약 품질 평가: 쌓인 점검 기록으로 AI 요약이 이상을 빠뜨리거나 과장하지 않는지 평가할 기준을 만들려고 합니다.
- 환불 경로 수정: 이 점검을 만들게 한 결제 확정 실패 경로에 결제 취소 호출을 연결하는 작업이 남아 있습니다.
규칙 표, 완료 기준, 배포 체크리스트는 설계 문서에 정리해 뒀습니다.